GPU cloud tốt nhất cho AI: thuê GPU ở đâu để chạy Stable Diffusion và fine-tune LLM
Thuê GPU theo giờ là cách rẻ nhất để chạy Stable Diffusion, fine-tune một LLM mã nguồn mở hoặc phục vụ mô hình mà không cần mua phần cứng. Nếu cần giá theo giờ thấp nhất, marketplace của Vast.ai thường thắng; nếu cần giá cố định, endpoint serverless và không phí egress, RunPod là lựa chọn đơn giản hơn. Hướng dẫn này dành cho lập trình viên, nhà nghiên cứu và người chơi tự trả tiền thuê GPU: giá niêm yết ngày 29 tháng 10 năm 2026, spot vs on-demand, lưu trữ và egress.
So sánh nhanh
| Dịch vụ | Phù hợp nhất cho | Giá từ | Gói miễn phí / dùng thử | Giới hạn chính | Đánh giá & đăng ký |
|---|---|---|---|---|---|
| RunPod | Giá GPU cố định tính theo giây, endpoint serverless, không phí egress | Từ $0,16/giờ (RTX A5000, Community Cloud) | Không có gói miễn phí; bắt đầu với $10, credit đăng ký sau $10 đầu tiên | Credit không hoàn lại; pod không có network volume bị xóa khi số dư về $0 | Đánh giá RunPod →Đến RunPod → |
| Vast.ai | Giá theo giờ thấp nhất và bid interruptible trên marketplace | Trung vị RTX 3090 ~$0,19/giờ (29/10/2026) | Không có gói miễn phí hay mã khuyến mãi | Giá do host đặt; lưu trữ và băng thông tính phí riêng | Đánh giá Vast.ai →Đến Vast.ai → |
| Timeweb Cloud | GPU data center đầy đủ (đến H100), thanh toán bằng rúp | Báo giá theo yêu cầu; trả trước tối thiểu 5.000 RUB | Không có dùng thử miễn phí | Không có bảng giá GPU công khai; gói tháng tính phí theo giờ | Đánh giá Timeweb Cloud →Đến Timeweb Cloud → |
| VDSina | Phần GPU L4/L40S nhỏ, trả bằng rúp, cho ứng dụng Windows và inference nhẹ | 4.770 RUB/tháng (159 RUB/ngày) | Không có dùng thử; tính phí theo ngày | 2–8 GB bộ nhớ GPU mỗi máy chủ | Đánh giá VDSina →Đến VDSina → |
Công khai: các nút đăng ký trong bảng này là liên kết tiếp thị liên kết. Nếu bạn đăng ký qua một trong số đó, chúng tôi có thể nhận hoa hồng mà bạn không phải trả thêm. Hoa hồng không quyết định việc chúng tôi đưa dịch vụ nào vào hay viết gì về chúng.
Câu trả lời ngắn gọn
Với hầu hết những ai thuê GPU theo giờ, lựa chọn nằm giữa hai mô hình:
- Chọn Vast.ai nếu giá là điều quan trọng nhất. Đây là một marketplace: các host độc lập và data center đăng máy của họ và tự đặt giá, nên bạn thường tìm được giá theo giờ thấp nhất ở đây, còn bid interruptible thì rẻ hơn nữa. Đổi lại, bạn mất tính ổn định: giá, độ tin cậy và chất lượng mạng khác nhau giữa các host.
- Chọn RunPod nếu bạn muốn giá cố định và không phải mất công tìm kiếm. RunPod công bố một mức giá theo giờ cho mỗi GPU, ở Community Cloud rẻ hơn và Secure Cloud đắt hơn, có thêm endpoint Serverless tự giảm về 0 khi không dùng, và không tính phí truyền dữ liệu.
Muốn thanh toán bằng rúp? Timeweb Cloud và VDSina cho thuê máy chủ GPU theo gói tháng. Giá dưới đây là giá niêm yết ngày 29 tháng 10 năm 2026; giá GPU thay đổi hằng tuần, vì vậy hãy kiểm tra trang giá hiện tại trước khi nạp tiền.
Cách chọn GPU cloud
Giá theo giờ chỉ là một dòng trong hóa đơn. Những gì quyết định chi phí thực tế:
- VRAM trước, tốc độ sau. Mô hình phải vừa bộ nhớ GPU. Tạo ảnh bằng Stable Diffusion hoặc ComfyUI và fine-tune LoRA cho các mô hình nhỏ thường chạy trên card phổ thông 24 GB (RTX 3090, 4090) hoặc RTX 5090 32 GB. Fine-tune toàn bộ hoặc phục vụ LLM lớn hơn sẽ đòi hỏi 48 GB (L40S) hoặc từ 80 GB trở lên (A100, H100, H200, B200).
- Mô hình giá. Bảng giá cố định (RunPod) so với giá marketplace do host tự đặt (Vast.ai).
- On-demand vs interruptible. Máy on-demand chạy đến khi bạn dừng nó. Máy interruptible (spot) rẻ hơn nhưng có thể bị lấy lại bất cứ lúc nào, nên phù hợp với tác vụ có lưu checkpoint.
- Lưu trữ và egress. Ổ đĩa thường vẫn bị tính phí khi GPU đã dừng, và một số nhà cung cấp tính tiền cho từng byte vào hoặc ra.
- Đơn vị tính phí và khoản nạp tối thiểu. Tính phí theo giây giúp các thử nghiệm ngắn rẻ hơn; khoản nạp tối thiểu cao hoặc credit không hoàn lại khiến việc thử một nhà cung cấp trở nên tốn kém.
- Serverless. Nếu bạn phục vụ mô hình qua API, chỉ trả tiền khi có request đang chạy có thể rẻ hơn việc bật GPU cả ngày.
- Độ tin cậy và dữ liệu. Ai sở hữu máy, và họ có thể xem dữ liệu của bạn không?
Marketplace vs Secure Cloud và Community Cloud
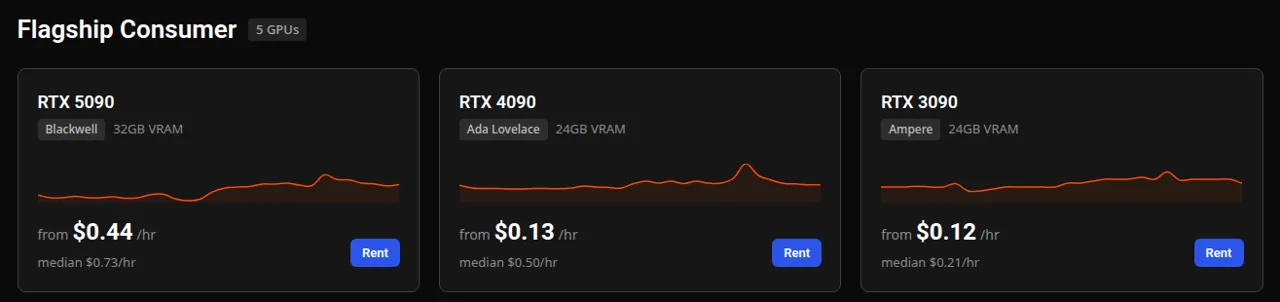
Trên trang giá của Vast.ai không có một mức giá duy nhất cho mỗi GPU. Các host cài phần mềm của Vast, đăng máy và tự đặt giá, tùy theo mẫu GPU, độ tin cậy, mạng và vị trí. Vast liệt kê hơn 68 loại GPU. Chính FAQ của Vast lưu ý rằng host có thể truy cập dữ liệu trên máy của họ, nên Vast khuyên dùng bộ lọc Secure Cloud (các data center đã được kiểm định, có chứng nhận ISO 27001 và/hoặc Tier 3/4) cho công việc nhạy cảm hoặc môi trường production.
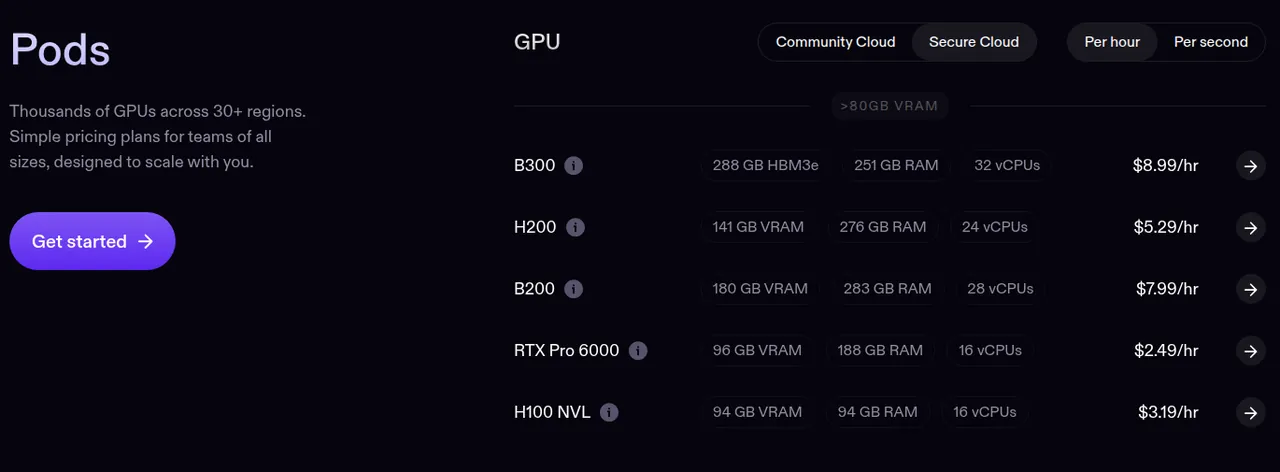
RunPod chia năng lực của mình làm hai. Community Cloud là năng lực rẻ hơn từ các host đã được kiểm định; Secure Cloud chạy trong data center của các đối tác RunPod. Cùng một GPU sẽ đắt hơn ở Secure Cloud: RTX 4090 có giá $0,34/giờ ở Community Cloud và $0,89/giờ ở Secure Cloud theo trang giá của RunPod.
Với một buổi chạy cho vui hoặc fine-tune trên dataset công khai, gói rẻ hơn là đủ; với dữ liệu khách hàng hoặc trọng số mô hình riêng, hãy trả tiền cho gói đã được kiểm định.
Bảng so sánh giá GPU
Giá RunPod là giá pod on-demand được công bố. Giá Vast.ai là mức trung vị hiện tại của các offer đang hoạt động trong feed giá công khai của Vast; từng host niêm yết cao hơn hoặc thấp hơn mức trung vị. Tất cả tính theo GPU mỗi giờ, giá niêm yết ngày 29 tháng 10 năm 2026.
| GPU | VRAM | RunPod Community | RunPod Secure | Trung vị Vast.ai |
|---|---|---|---|---|
| RTX 3090 | 24 GB | $0,22 | $0,50 | $0,19 |
| RTX 4090 | 24 GB | $0,34 | $0,89 | $0,50 |
| RTX 5090 | 32 GB | $0,69 | $1,19 | $0,71 |
| L40S | 48 GB | $0,79 | $1,09 | $0,69 |
| A100 SXM | 80 GB | $1,39 | $1,79 | $0,80 |
| H100 SXM | 80 GB | $2,69 | $3,99 | $2,40 |
| H200 | 141 GB | $3,59 | $5,29 | $5,05 |
| B200 | 180–192 GB | $5,98 | $7,99 | $8,75 |
Trên marketplace, RTX 3090 và A100 có giá thấp hơn mức giá cố định của RunPod (và trung vị RTX 3060 khoảng $0,08/giờ), trong khi với H200 và B200, giá Community của RunPod thấp hơn vào ngày hôm đó. Không bên nào luôn rẻ hơn: hãy so sánh đúng mẫu GPU vào ngày bạn thuê.
RunPod: tốt nhất cho pod giá ổn định và serverless
RunPod cho thuê GPU NVIDIA từ RTX A5000 ($0,16/giờ ở Community Cloud) đến H200, B200 và B300. Các sản phẩm:
- Pods: instance GPU truy cập qua SSH hoặc Jupyter.
- Serverless: endpoint tự giảm về 0 khi rảnh, tính phí theo từng giây thời gian worker, ví dụ $0,69/giờ cho GPU 24 GB, $4,79/giờ cho H100.
- Clusters: năng lực nhiều GPU cho huấn luyện phân tán.
Theo tài liệu thanh toán của RunPod, điện toán và lưu trữ được tính phí theo giây, không có phí truyền dữ liệu, và bạn có thể bắt đầu với $10. Chi phí khi máy rảnh đến từ lưu trữ: volume disk có giá $0,10/GB mỗi tháng khi pod đang chạy và $0,20/GB mỗi tháng khi pod đã dừng; network volume là $0,07/GB mỗi tháng với dung lượng dưới 1 TB.
Chọn RunPod nếu bạn muốn giá theo giờ rõ ràng, phục vụ mô hình có thể giảm về 0, hoặc không có hóa đơn egress.
Nhược điểm: credit không được hoàn lại. Khi số dư về 0, các pod dừng lại và pod không có network volume sẽ bị xóa cùng dữ liệu. Trang giá không hiển thị giá spot. Chi tiết và credit khi đăng ký có trong bài đánh giá RunPod của chúng tôi.
Vast.ai: tốt nhất cho giá theo giờ thấp nhất
Thế mạnh của Vast.ai là sự lựa chọn: lọc offer theo GPU, VRAM, độ tin cậy, vị trí và giá, rồi thuê máy dưới dạng instance Docker Linux qua SSH, Jupyter hoặc cổng web. API, CLI và Python SDK giúp bạn tự động hóa việc khởi chạy bằng script.
Ba hình thức thuê, theo tài liệu về hình thức thuê của Vast:
- On-demand: giá cố định của host; không bị gián đoạn.
- Interruptible: bạn đặt bid, và một bid cao hơn có thể dừng instance của bạn, khiến các tiến trình đang chạy bị tắt. Vast cho biết mức tiết kiệm là 50–80% so với on-demand. Hãy lưu checkpoint thường xuyên.
- Reserved: trả trước để được giảm giá tới 50% tùy thời hạn cam kết, kèm ưu tiên như on-demand.
Các lượt thuê đang hoạt động được tính phí theo giây. Điểm cần lưu ý nằm trong FAQ thanh toán của Vast: lưu trữ vẫn bị tính phí với instance đã dừng, và băng thông bị tính cho từng byte gửi hoặc nhận. Khi credit của bạn về 0, instance bị dừng nhưng không bị xóa. Tài liệu của Vast không nêu khoản nạp tối thiểu.
Chọn Vast.ai nếu bạn muốn giờ GPU rẻ nhất và tác vụ của bạn lưu checkpoint đủ tốt để dùng bid interruptible.
Nhược điểm: giá và chất lượng host không đồng đều; ngoài Secure Cloud, host có thể truy cập dữ liệu trên máy của họ; không có Windows hay remote desktop. Xem thêm trong bài đánh giá Vast.ai của chúng tôi.
RunPod vs Vast.ai: chọn bên nào cho công việc của bạn
- Chạy Stable Diffusion hoặc ComfyUI vài giờ: cả hai đều được. Offer RTX 3090 và 4090 trên Vast.ai thường rẻ nhất; template một cú nhấp và giá RTX 4090 cố định của RunPod thì đơn giản hơn. Dù chọn bên nào, hãy xóa ổ đĩa khi xong việc, nếu không nó sẽ tiếp tục bị tính phí.
- Fine-tune LLM trong một cuối tuần: dùng bid interruptible của Vast.ai nếu script của bạn lưu checkpoint; dùng on-demand của RunPod hoặc Vast nếu một lần khởi động lại khiến bạn tốn hơn khoản tiết kiệm.
- Phục vụ mô hình dưới dạng API: RunPod Serverless là lựa chọn phù hợp nhất, vì endpoint giảm về 0 và không có phí egress cho phản hồi.
- Dataset lớn: RunPod không tính phí truyền dữ liệu; trên Vast.ai, hãy kiểm tra giá băng thông của từng host.
- Dữ liệu nhạy cảm: RunPod Secure Cloud hoặc bộ lọc Secure Cloud của Vast.ai.
- Dù chọn bên nào: credit là trả trước (credit của RunPod không được hoàn lại; trên Vast.ai, credit đã tiêu là không thể lấy lại), vì vậy hãy nạp đủ dùng cho một tuần, không phải một năm, và xóa các instance đã dùng xong, vì ổ đĩa đã dừng vẫn bị tính phí.
Thanh toán bằng rúp: Timeweb Cloud và VDSina
Timeweb Cloud liệt kê máy chủ GPU cloud và dedicated từ GTX 1080 và RTX 3090/4090 đến A100 80 GB và H100 80 GB, còn H200 thì nhận đặt trước, trên trang máy chủ GPU của họ. Giá không được công bố: bạn gửi yêu cầu và quản lý sẽ báo giá, với khoản trả trước tối thiểu 5.000 RUB. Gói được đặt theo tháng nhưng tính phí theo giờ. Xem bài đánh giá Timeweb Cloud.
VDSina bán máy chủ cloud kèm một phần GPU NVIDIA L4 hoặc L40S trên trang giá GPU của họ: từ 4.770 RUB mỗi tháng (159 RUB mỗi ngày) cho 8 nhân, 8 GB RAM và 2 GB bộ nhớ GPU, đến 25.500 RUB mỗi tháng cho 32 nhân và 8 GB bộ nhớ GPU, đặt tại Moskva hoặc Amsterdam. Tính phí theo ngày và không có dùng thử. Với 2–8 GB bộ nhớ GPU, các máy này phù hợp với ứng dụng Windows, render và inference nhẹ, không phải quy trình Stable Diffusion cần card 24 GB hay fine-tune LLM. Xem bài đánh giá VDSina.
Còn Lambda, Paperspace, AWS và Google Cloud thì sao?
Đều là lựa chọn thực sự, nhưng hiếm khi có giờ GPU rẻ nhất. Lambda niêm yết 1x H100 SXM giá $4,29/giờ trên trang giá của họ (29 tháng 10 năm 2026), còn năng lực reserved thì qua bộ phận bán hàng. Paperspace, nay thuộc DigitalOcean, cung cấp máy GPU lấy notebook làm trọng tâm. AWS và Google Cloud có phạm vi region và tuân thủ rộng nhất, nhưng hạn mức (quota) và phí egress khiến chúng phù hợp hơn với các đội vốn đã chạy hạ tầng ở đó.
Với VPS, lưu trữ và hạ tầng khác, hãy xem dịch vụ hosting và cloud.
Câu hỏi thường gặp
GPU cloud nào rẻ nhất?
Tính theo giờ, các marketplace như Vast.ai thường có giá thấp nhất: ngày 29 tháng 10 năm 2026, feed của họ cho thấy trung vị RTX 3090 khoảng $0,19/giờ và RTX 3060 khoảng $0,08/giờ. GPU rẻ nhất được niêm yết trên RunPod là RTX A5000 với giá $0,16/giờ ở Community Cloud. Hãy cộng thêm chi phí lưu trữ và băng thông trước khi quyết định.
RunPod vs Vast.ai: nên dùng bên nào?
Dùng Vast.ai khi giá theo giờ thấp nhất là ưu tiên hàng đầu và bạn chấp nhận được giá do host đặt cùng chất lượng không đồng đều. Dùng RunPod khi bạn muốn bảng giá cố định, endpoint Serverless tự giảm về 0 và không phí truyền dữ liệu.
Cần thuê GPU nào để chạy Stable Diffusion?
Hầu hết mọi người dùng card 24 GB như RTX 3090 hoặc 4090, đủ chỗ cho các mô hình lớn hơn và quy trình ComfyUI. Hãy kiểm tra yêu cầu bộ nhớ của đúng mô hình bạn chạy. Trên cả RunPod và Vast.ai, đây là những card thuộc nhóm rẻ nhất để thuê.
Cần GPU nào để fine-tune LLM?
Tùy vào kích thước mô hình và phương pháp. Fine-tune kiểu LoRA cho các mô hình nhỏ thường chạy trên card 24–48 GB, còn fine-tune toàn bộ hoặc mô hình lớn hơn cần card 80 GB như A100 hoặc H100. Hãy xem hướng dẫn về bộ nhớ của framework huấn luyện trước khi thuê.
GPU interruptible hay spot có đáng dùng không?
Có, với các tác vụ lưu checkpoint, vì Vast.ai cho biết interruptible rẻ hơn on-demand 50–80%. Khi một bid cao hơn lấy mất máy của bạn, các tiến trình đang chạy sẽ bị tắt, nên chúng không phù hợp cho demo trực tiếp hay các lượt chạy dài không có checkpoint.