Meilleur cloud GPU pour l'IA : où louer un GPU pour Stable Diffusion et le fine-tuning de LLM
Louer un GPU à l'heure est le moyen le plus économique de faire tourner Stable Diffusion, de fine-tuner un LLM open source ou de servir un modèle sans acheter de matériel. Pour le prix horaire le plus bas, la marketplace de Vast.ai l'emporte en général ; pour des prix fixes, des endpoints serverless et aucun frais d'egress, RunPod est le choix le plus simple. Ce guide s'adresse aux développeurs, chercheurs et passionnés qui paient eux-mêmes leur temps GPU : prix relevés le 29 octobre 2026, spot ou à la demande, stockage et egress.
Comparatif en un coup d'œil
| Service | Idéal pour | Prix de départ | Offre gratuite / essai | Limite principale | Avis et inscription |
|---|---|---|---|---|---|
| RunPod | Prix GPU fixes à la seconde, endpoints serverless, pas de frais d'egress | À partir de 0,16 $/h (RTX A5000, Community Cloud) | Pas d'offre gratuite ; démarrage avec 10 $, crédit d'inscription après les 10 premiers $ | Crédits non remboursables ; pods sans network volume supprimés à 0 $ | Avis sur RunPod →Accéder à RunPod → |
| Vast.ai | Prix horaires les plus bas et enchères interruptibles sur une marketplace | RTX 3090 médiane ~0,19 $/h (29 oct. 2026) | Ni offre gratuite ni code promo | Prix fixés par les hébergeurs ; stockage et bande passante facturés à part | Avis sur Vast.ai →Accéder à Vast.ai → |
| Timeweb Cloud | GPU de datacenter complets (jusqu'au H100) facturés en roubles | Devis sur demande ; paiement anticipé minimum de 5 000 RUB | Pas d'essai gratuit | Pas de grille publique de prix GPU ; forfaits mensuels facturés à l'heure | Avis sur Timeweb Cloud →Accéder à Timeweb Cloud → |
| VDSina | Petites fractions de GPU L4/L40S en roubles pour applis Windows et inférence légère | 4 770 RUB/mois (159 RUB/jour) | Pas d'essai ; facturation journalière | 2 à 8 Go de mémoire GPU par serveur | Avis sur VDSina →Accéder à VDSina → |
Transparence : les boutons d'inscription de ce tableau sont des liens d'affiliation. Si vous vous inscrivez via l'un d'eux, nous pouvons percevoir une commission, sans surcoût pour vous. Les commissions ne décident ni des services que nous incluons ni de ce que nous en disons.
La réponse courte
Pour la plupart des gens qui louent un GPU à l'heure, le choix se joue entre deux modèles :
- Choisissez Vast.ai si le prix compte avant tout. C'est une marketplace : des hébergeurs indépendants et des datacenters y proposent leurs machines et fixent leurs propres tarifs. C'est donc là que vous trouverez en général le prix horaire le plus bas, et les enchères interruptibles descendent encore plus bas. En contrepartie, vous perdez en prévisibilité : prix, fiabilité et qualité réseau varient d'un hébergeur à l'autre.
- Choisissez RunPod si vous voulez des prix fixes et moins de recherche. Il publie un tarif horaire unique par GPU, dans un Community Cloud moins cher et un Secure Cloud plus coûteux, propose des endpoints Serverless qui descendent à zéro et ne facture aucun frais de transfert de données.
Vous payez en roubles ? Timeweb Cloud et VDSina louent des serveurs GPU avec des forfaits mensuels. Les prix ci-dessous sont ceux affichés le 29 octobre 2026 ; les tarifs GPU bougent chaque semaine, vérifiez donc la page en direct avant de recharger votre compte.
Comment choisir un cloud GPU
Le tarif horaire n'est qu'une ligne de la facture. Voici ce qui détermine le coût réel :
- D'abord la VRAM, ensuite la vitesse. Le modèle doit tenir dans la mémoire du GPU. La génération d'images avec Stable Diffusion ou ComfyUI et le fine-tuning LoRA de petits modèles se font généralement sur des cartes grand public de 24 Go (RTX 3090, 4090) ou sur la RTX 5090 de 32 Go. Le fine-tuning complet ou le service de LLM plus gros vous pousse vers 48 Go (L40S) ou 80 Go et plus (A100, H100, H200, B200).
- Modèle de prix. Une grille tarifaire fixe (RunPod) ou des prix de marketplace fixés par les hébergeurs (Vast.ai).
- À la demande ou interruptible. La capacité à la demande tourne jusqu'à ce que vous l'arrêtiez. La capacité interruptible (spot) est moins chère mais peut vous être retirée : elle convient aux tâches qui enregistrent des checkpoints.
- Stockage et egress. Les disques continuent souvent d'être facturés quand le GPU est arrêté, et certains fournisseurs facturent chaque octet entrant ou sortant.
- Granularité de facturation et dépôt minimum. La facturation à la seconde rend les expériences courtes bon marché ; un dépôt minimum élevé ou un crédit non remboursable rend l'essai d'un fournisseur coûteux.
- Serverless. Si vous servez un modèle derrière une API, ne payer que pendant l'exécution des requêtes peut revenir moins cher que de garder un GPU allumé toute la journée.
- Confiance et données. À qui appartient la machine, et cette personne peut-elle voir vos données ?
Marketplace ou Secure et Community Cloud
Sur la page de tarifs de Vast.ai, il n'existe pas de prix unique par GPU. Les hébergeurs installent le logiciel de Vast, mettent leurs machines en location et fixent le tarif, qui dépend du modèle de GPU, de la fiabilité, du réseau et de la localisation. Vast référence plus de 68 types de GPU. La FAQ de Vast elle-même précise que les hébergeurs peuvent accéder aux données présentes sur leurs machines ; elle recommande donc son filtre Secure Cloud (datacenters vérifiés, certifiés ISO 27001 et/ou Tier 3/4) pour les travaux sensibles ou en production.
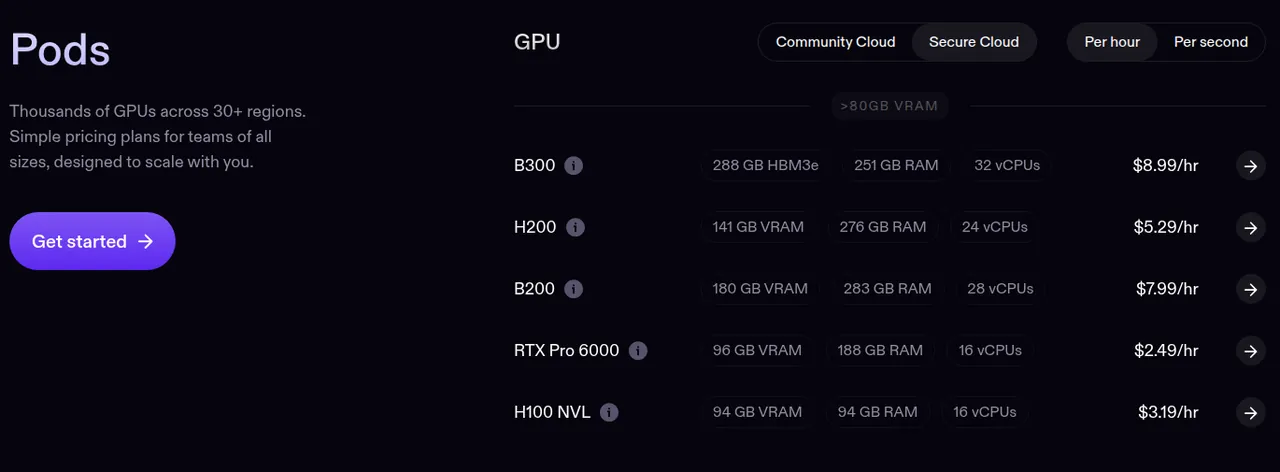
RunPod divise sa capacité en deux. Community Cloud est une capacité moins chère fournie par des hébergeurs vérifiés ; Secure Cloud tourne chez les datacenters partenaires de RunPod. Le même GPU coûte plus cher en Secure Cloud : une RTX 4090 est à 0,34 $/h en Community Cloud et à 0,89 $/h en Secure Cloud sur la page de tarifs de RunPod.
Pour une session de loisir ou un fine-tuning sur un jeu de données public, le niveau le moins cher suffit ; pour des données clients ou des poids privés, payez pour le niveau vérifié.
Les prix GPU côte à côte
Les tarifs RunPod sont ses prix publiés pour les pods à la demande. Les tarifs Vast.ai correspondent à la médiane actuelle des offres en ligne dans le flux de prix public de Vast ; chaque hébergeur affiche des prix au-dessus ou en dessous de cette médiane. Tous les prix sont par GPU et par heure, relevés le 29 octobre 2026.
| GPU | VRAM | RunPod Community | RunPod Secure | Médiane Vast.ai |
|---|---|---|---|---|
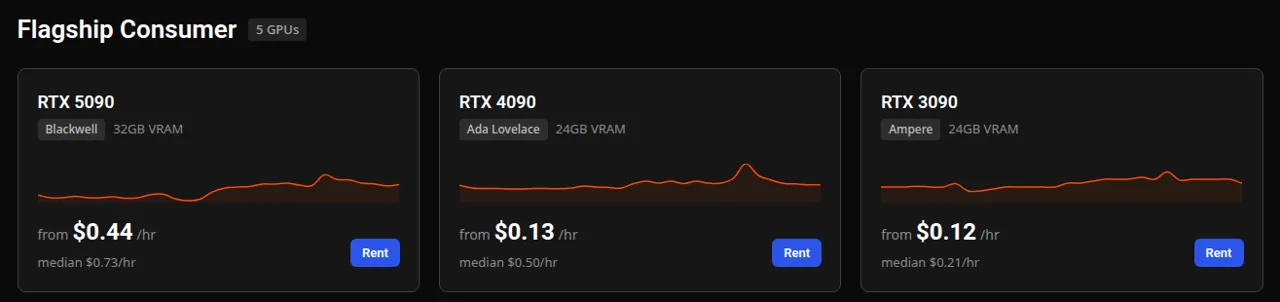
| RTX 3090 | 24 Go | 0,22 $ | 0,50 $ | 0,19 $ |
| RTX 4090 | 24 Go | 0,34 $ | 0,89 $ | 0,50 $ |
| RTX 5090 | 32 Go | 0,69 $ | 1,19 $ | 0,71 $ |
| L40S | 48 Go | 0,79 $ | 1,09 $ | 0,69 $ |
| A100 SXM | 80 Go | 1,39 $ | 1,79 $ | 0,80 $ |
| H100 SXM | 80 Go | 2,69 $ | 3,99 $ | 2,40 $ |
| H200 | 141 Go | 3,59 $ | 5,29 $ | 5,05 $ |
| B200 | 180–192 Go | 5,98 $ | 7,99 $ | 8,75 $ |
Sur la marketplace, la RTX 3090 et l'A100 sont ressorties sous les tarifs fixes de RunPod (et la médiane d'une RTX 3060 tournait autour de 0,08 $/h), tandis que sur le H200 et le B200, les tarifs Community de RunPod étaient plus bas ce jour-là. Aucun des deux n'est toujours le moins cher : comparez le GPU exact le jour de la location.
RunPod : idéal pour des pods prévisibles et le serverless
RunPod loue des GPU NVIDIA, de la RTX A5000 (0,16 $/h en Community Cloud) jusqu'aux H200, B200 et B300. Ses produits :
- Pods : des instances GPU accessibles en SSH ou via Jupyter.
- Serverless : des endpoints qui descendent à zéro au repos, facturés à la seconde de temps de worker, par exemple 0,69 $/h pour les GPU de 24 Go et 4,79 $/h pour un H100.
- Clusters : de la capacité multi-GPU pour l'entraînement distribué.
Selon la documentation de facturation de RunPod, le calcul et le stockage sont facturés à la seconde, sans frais de transfert de données, et vous pouvez démarrer avec 10 $. C'est le stockage qui génère des coûts à l'arrêt : un volume disk coûte 0,10 $/Go par mois quand le pod tourne et 0,20 $/Go par mois quand il est arrêté ; les network volumes coûtent 0,07 $/Go par mois en dessous de 1 To.
Choisissez RunPod si vous voulez un tarif horaire connu à l'avance, un service qui descend à zéro ou aucune facture d'egress.
Les inconvénients : les crédits ne sont pas remboursables. À solde nul, les pods s'arrêtent et ceux sans network volume sont supprimés avec leurs données. La page de tarifs n'affiche aucun prix spot. Les détails et le crédit d'inscription sont dans notre avis sur RunPod.
Vast.ai : idéal pour le prix horaire le plus bas
La force de Vast.ai, c'est le choix : filtrez les offres par GPU, VRAM, fiabilité, localisation et prix, puis louez la machine sous forme d'instance Docker Linux via SSH, Jupyter ou un portail web. Une API, une CLI et un SDK Python permettent d'automatiser les lancements.
Trois types de location, d'après la documentation de Vast sur les types de location :
- On-demand : le tarif fixe de l'hébergeur ; l'instance ne peut pas être interrompue.
- Interruptible : vous fixez une enchère, et une enchère plus élevée peut arrêter votre instance, ce qui tue les processus en cours. Vast annonce une économie de 50 à 80 % par rapport à l'on-demand. Enregistrez des checkpoints souvent.
- Reserved : payez d'avance pour une remise allant jusqu'à 50 % selon la durée d'engagement, avec la priorité de l'on-demand.
Les locations actives sont facturées à la seconde. Le piège se trouve dans la FAQ facturation de Vast : le stockage est aussi facturé pour les instances arrêtées, et la bande passante est facturée pour chaque octet envoyé ou reçu. Quand votre crédit tombe à zéro, les instances sont arrêtées mais pas détruites. La documentation de Vast n'indique pas de dépôt minimum.
Choisissez Vast.ai si vous voulez l'heure de GPU la moins chère et que vos tâches enregistrent assez de checkpoints pour supporter les enchères interruptibles.
Les inconvénients : les prix et la qualité des hébergeurs varient ; hors Secure Cloud, un hébergeur peut accéder aux données de sa machine ; pas de Windows ni de bureau à distance. Plus de détails dans notre avis sur Vast.ai.
RunPod ou Vast.ai : lequel pour votre usage
- Stable Diffusion ou ComfyUI pendant quelques heures : les deux conviennent. Les offres RTX 3090 et 4090 de Vast.ai sont généralement les moins chères ; les templates en un clic de RunPod et son tarif fixe pour la RTX 4090 sont plus simples. Dans les deux cas, supprimez le disque une fois terminé, sinon il continue d'être facturé.
- Fine-tuning de LLM sur un week-end : les enchères interruptibles de Vast.ai si votre script enregistre des checkpoints ; RunPod ou Vast en on-demand si un redémarrage vous coûterait plus que l'économie réalisée.
- Servir un modèle via une API : RunPod Serverless est la solution la plus directe, car les endpoints descendent à zéro et les réponses ne génèrent aucun frais d'egress.
- Gros jeux de données : RunPod ne facture aucun transfert de données ; sur Vast.ai, vérifiez le prix de la bande passante de chaque hébergeur.
- Données sensibles : RunPod Secure Cloud ou le filtre Secure Cloud de Vast.ai.
- Dans tous les cas : le crédit est prépayé (celui de RunPod n'est pas remboursable ; sur Vast.ai, le crédit dépensé est définitif), alors rechargez pour la semaine, pas pour l'année, et détruisez les instances dont vous n'avez plus besoin, car les disques arrêtés restent facturés.
Payer en roubles : Timeweb Cloud et VDSina
Timeweb Cloud propose des serveurs GPU cloud et dédiés, de la GTX 1080 et des RTX 3090/4090 jusqu'aux A100 80 Go et H100 80 Go, le H200 étant en précommande, sur sa page serveurs GPU. Les prix ne sont pas publiés : vous laissez une demande et un commercial vous fait un devis, avec un paiement anticipé minimum de 5 000 RUB. Les forfaits sont mensuels mais facturés à l'heure. Voir l'avis sur Timeweb Cloud.
VDSina vend des serveurs cloud avec une fraction d'une NVIDIA L4 ou L40S sur sa page de tarifs GPU : de 4 770 RUB par mois (159 RUB par jour) pour 8 cœurs, 8 Go de RAM et 2 Go de mémoire GPU, jusqu'à 25 500 RUB par mois pour 32 cœurs et 8 Go de mémoire GPU, à Moscou ou à Amsterdam. La facturation est journalière et il n'y a pas d'essai. Avec 2 à 8 Go de mémoire GPU, ces serveurs conviennent aux applications Windows, au rendu et à l'inférence légère, pas aux workflows Stable Diffusion de la classe 24 Go ni au fine-tuning de LLM. Voir l'avis sur VDSina.
Et Lambda, Paperspace, AWS ou Google Cloud ?
Ce sont de vraies options, rarement l'heure la moins chère. Lambda affiche un H100 SXM à 1 GPU à 4,29 $/h sur sa page de tarifs (29 octobre 2026), la capacité réservée passant par l'équipe commerciale. Paperspace, désormais intégré à DigitalOcean, propose des machines GPU pensées d'abord pour les notebooks. AWS et Google Cloud offrent la plus large couverture de régions et de conformité, mais les quotas et les frais d'egress les destinent plutôt aux équipes qui y travaillent déjà.
Pour les VPS, le stockage et le reste de l'infrastructure, parcourez les services d'hébergement et de cloud.
Questions fréquentes
Quel est le cloud GPU le moins cher ?
À l'heure, les marketplaces comme Vast.ai affichent généralement les prix les plus bas : le 29 octobre 2026, son flux indiquait une médiane d'environ 0,19 $/h pour une RTX 3090 et d'environ 0,08 $/h pour une RTX 3060. Le GPU le moins cher listé par RunPod était une RTX A5000 à 0,16 $/h en Community Cloud. Ajoutez le stockage et la bande passante avant de décider.
RunPod ou Vast.ai : lequel choisir ?
Prenez Vast.ai quand le prix horaire le plus bas compte avant tout et que vous acceptez des prix fixés par les hébergeurs et une qualité variable. Prenez RunPod si vous voulez une grille de prix fixe, des endpoints Serverless qui descendent à zéro et aucun frais de transfert de données.
Quel GPU louer pour Stable Diffusion ?
La plupart des gens utilisent une carte de 24 Go comme la RTX 3090 ou 4090, qui laisse de la place pour les modèles plus gros et les workflows ComfyUI. Vérifiez les besoins en mémoire du modèle exact que vous utilisez. Sur RunPod comme sur Vast.ai, ces cartes font partie des moins chères à louer.
Quel GPU faut-il pour le fine-tuning d'un LLM ?
Cela dépend de la taille du modèle et de la méthode. Le fine-tuning de type LoRA sur de petits modèles se fait couramment sur des cartes de 24 à 48 Go, tandis que le fine-tuning complet ou les modèles plus gros demandent des cartes de 80 Go comme l'A100 ou le H100. Consultez les recommandations mémoire de votre framework d'entraînement avant de louer.
Les GPU interruptibles ou spot valent-ils le coup ?
Oui pour les tâches qui enregistrent des checkpoints, puisque Vast.ai annonce des économies de 50 à 80 % par rapport à l'on-demand en mode interruptible. Quand une enchère plus élevée vous prend la machine, les processus en cours sont tués : ils conviennent donc mal aux démos en direct ou aux longs calculs sans checkpoints.