GPU cloud terbaik untuk AI: tempat sewa GPU untuk Stable Diffusion dan fine-tuning LLM
Menyewa GPU per jam adalah cara termurah untuk menjalankan Stable Diffusion, melakukan fine-tuning LLM open source, atau menyajikan model tanpa membeli hardware. Untuk harga per jam terendah, marketplace Vast.ai biasanya unggul; untuk harga tetap, endpoint serverless, dan tanpa biaya egress, RunPod pilihan yang lebih praktis. Panduan ini untuk developer, peneliti, dan penghobi yang membayar waktu GPU sendiri: harga per 29 Oktober 2026, spot vs on-demand, storage, dan egress.
Perbandingan singkat
| Layanan | Paling cocok untuk | Harga mulai | Paket gratis / uji coba | Batasan utama | Ulasan & pendaftaran |
|---|---|---|---|---|---|
| RunPod | Harga GPU tetap per detik, endpoint serverless, tanpa biaya egress | Mulai $0,16/jam (RTX A5000, Community Cloud) | Tanpa paket gratis; mulai dengan $10, kredit pendaftaran setelah $10 pertama | Kredit tidak bisa dikembalikan; pod tanpa network volume dihapus saat saldo $0 | Ulasan RunPod →Buka RunPod → |
| Vast.ai | Harga per jam terendah dan bid interruptible di marketplace | Median RTX 3090 ~$0,19/jam (29 Okt 2026) | Tanpa paket gratis atau kode promo | Harga ditentukan host; storage dan bandwidth ditagih terpisah | Ulasan Vast.ai →Buka Vast.ai → |
| Timeweb Cloud | GPU data center penuh (hingga H100) dengan tagihan dalam rubel | Harga berdasarkan permintaan; minimum bayar di muka 5.000 RUB | Tanpa uji coba gratis | Tidak ada daftar harga GPU publik; paket bulanan ditagih per jam | Ulasan Timeweb Cloud →Buka Timeweb Cloud → |
| VDSina | Potongan kecil GPU L4/L40S dalam rubel untuk aplikasi Windows dan inferensi ringan | 4.770 RUB/bulan (159 RUB/hari) | Tanpa uji coba; ditagih per hari | Memori GPU 2–8 GB per server | Ulasan VDSina →Buka VDSina → |
Pengungkapan: tombol pendaftaran di tabel ini adalah tautan afiliasi. Jika Anda mendaftar melalui salah satunya, kami mungkin mendapat komisi tanpa biaya tambahan bagi Anda. Komisi tidak menentukan layanan mana yang kami masukkan atau apa yang kami tulis tentangnya.
Jawaban singkat
Bagi kebanyakan orang yang menyewa GPU per jam, pilihannya ada di antara dua model:
- Pilih Vast.ai jika harga adalah yang terpenting. Ini adalah marketplace: host independen dan data center memasang mesin mereka dan menentukan tarif sendiri, sehingga Anda biasanya menemukan harga per jam terendah di sana, dan bid interruptible bisa lebih murah lagi. Konsekuensinya, Anda kehilangan kepastian: harga, keandalan, dan kualitas jaringan berbeda dari satu host ke host lain.
- Pilih RunPod jika Anda ingin harga tetap dan tidak perlu repot mencari. RunPod menerbitkan satu tarif per jam untuk setiap GPU, di Community Cloud yang lebih murah dan Secure Cloud yang lebih mahal, menyediakan endpoint Serverless yang bisa turun ke nol, dan tidak memungut biaya transfer data.
Ingin membayar dalam rubel? Timeweb Cloud dan VDSina menyewakan server GPU dengan paket bulanan. Harga di bawah ini sesuai daftar per 29 Oktober 2026; tarif GPU berubah setiap minggu, jadi periksa halaman terbarunya sebelum Anda mengisi saldo.
Cara memilih GPU cloud
Tarif per jam hanyalah satu baris di tagihan. Yang menentukan biaya sebenarnya:
- VRAM dulu, baru kecepatan. Model harus muat di memori GPU. Pembuatan gambar dengan Stable Diffusion atau ComfyUI dan fine-tuning LoRA untuk model yang lebih kecil biasanya dilakukan di kartu konsumen 24 GB (RTX 3090, 4090) atau RTX 5090 dengan 32 GB. Fine-tuning penuh atau menyajikan LLM yang lebih besar menuntut 48 GB (L40S) atau 80 GB ke atas (A100, H100, H200, B200).
- Model harga. Daftar harga tetap (RunPod) versus harga marketplace yang ditentukan host (Vast.ai).
- On-demand vs interruptible. Kapasitas on-demand berjalan sampai Anda menghentikannya. Kapasitas interruptible (spot) lebih murah tetapi bisa diambil sewaktu-waktu, jadi cocok untuk pekerjaan yang menyimpan checkpoint.
- Storage dan egress. Disk sering tetap ditagih saat GPU dihentikan, dan sebagian penyedia memungut biaya untuk setiap byte yang masuk atau keluar.
- Granularitas penagihan dan deposit minimum. Penagihan per detik membuat eksperimen singkat jadi murah; deposit minimum yang tinggi atau kredit yang tidak bisa dikembalikan membuat mencoba penyedia baru jadi mahal.
- Serverless. Jika Anda menyajikan model di balik API, membayar hanya saat request berjalan bisa lebih hemat daripada menyalakan GPU seharian.
- Kepercayaan dan data. Siapa pemilik mesinnya, dan apakah mereka bisa melihat data Anda?
Marketplace vs Secure Cloud dan Community Cloud
Di halaman harga Vast.ai tidak ada satu harga tunggal per GPU. Host memasang software Vast, mendaftarkan mesin mereka, dan menentukan tarif, yang bergantung pada model GPU, keandalan, jaringan, dan lokasi. Vast mencantumkan 68+ jenis GPU. FAQ Vast sendiri menyebutkan bahwa host dapat mengakses data di mesin mereka, sehingga Vast menyarankan filter Secure Cloud (data center terverifikasi dengan sertifikasi ISO 27001 dan/atau Tier 3/4) untuk pekerjaan sensitif atau produksi.
RunPod membagi kapasitasnya menjadi dua. Community Cloud adalah kapasitas lebih murah dari host terverifikasi; Secure Cloud berjalan di data center mitra RunPod. GPU yang sama lebih mahal di Secure Cloud: RTX 4090 dihargai $0,34/jam di Community Cloud dan $0,89/jam di Secure Cloud menurut halaman harga RunPod.
Untuk sesi hobi atau fine-tuning dengan dataset publik, tier yang lebih murah sudah cukup; untuk data klien atau bobot model pribadi, bayarlah tier yang terverifikasi.
Perbandingan harga GPU
Tarif RunPod adalah harga pod on-demand yang dipublikasikan. Tarif Vast.ai adalah median penawaran aktif saat ini di feed harga publik Vast; masing-masing host memasang harga di atas maupun di bawah median. Semua per GPU per jam, sesuai daftar per 29 Oktober 2026.
| GPU | VRAM | RunPod Community | RunPod Secure | Median Vast.ai |
|---|---|---|---|---|
| RTX 3090 | 24 GB | $0,22 | $0,50 | $0,19 |
| RTX 4090 | 24 GB | $0,34 | $0,89 | $0,50 |
| RTX 5090 | 32 GB | $0,69 | $1,19 | $0,71 |
| L40S | 48 GB | $0,79 | $1,09 | $0,69 |
| A100 SXM | 80 GB | $1,39 | $1,79 | $0,80 |
| H100 SXM | 80 GB | $2,69 | $3,99 | $2,40 |
| H200 | 141 GB | $3,59 | $5,29 | $5,05 |
| B200 | 180–192 GB | $5,98 | $7,99 | $8,75 |
Di marketplace, RTX 3090 dan A100 lebih murah daripada tarif tetap RunPod (dan median RTX 3060 sekitar $0,08/jam), sementara untuk H200 dan B200 tarif Community RunPod lebih rendah pada hari itu. Tidak ada yang selalu lebih murah: bandingkan GPU yang persis Anda butuhkan pada hari Anda menyewa.
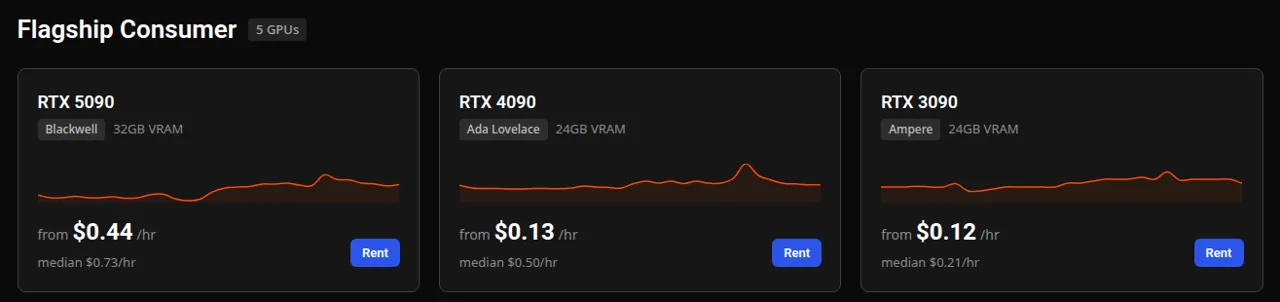
RunPod: terbaik untuk pod dengan harga pasti dan serverless
RunPod menyewakan GPU NVIDIA mulai dari RTX A5000 ($0,16/jam di Community Cloud) hingga H200, B200, dan B300. Produknya:
- Pods: instance GPU lewat SSH atau Jupyter.
- Serverless: endpoint yang turun ke nol saat idle, ditagih per detik waktu worker, misalnya $0,69/jam untuk GPU 24 GB, $4,79/jam untuk H100.
- Clusters: kapasitas multi-GPU untuk pelatihan terdistribusi.
Menurut dokumentasi penagihan RunPod, komputasi dan storage ditagih per detik tanpa biaya transfer data, dan Anda bisa mulai dengan $10. Biaya saat idle datang dari storage: volume disk dikenai $0,10/GB per bulan selama pod berjalan dan $0,20/GB per bulan saat pod dihentikan; network volume $0,07/GB per bulan untuk kapasitas di bawah 1 TB.
Pilih RunPod jika Anda menginginkan tarif per jam yang pasti, penyajian model yang bisa turun ke nol, atau tanpa tagihan egress.
Kekurangannya: kredit tidak bisa dikembalikan. Saat saldo nol, pod berhenti dan pod tanpa network volume dihapus beserta datanya. Halaman harga tidak menampilkan tarif spot. Detail dan kredit pendaftaran ada di ulasan RunPod kami.
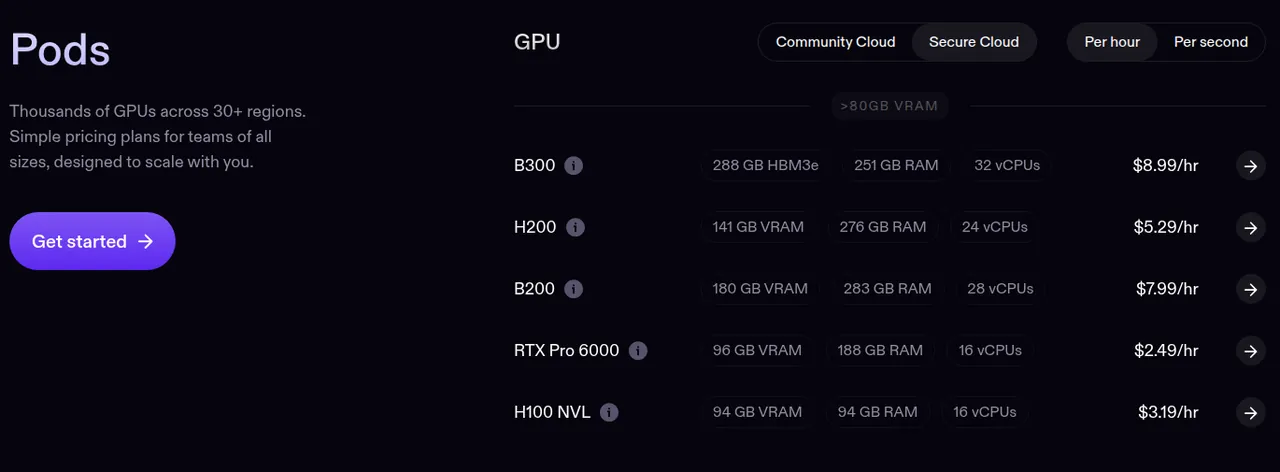
Vast.ai: terbaik untuk harga per jam terendah
Kekuatan Vast.ai adalah pilihan: saring penawaran berdasarkan GPU, VRAM, keandalan, lokasi, dan harga, lalu sewa mesinnya sebagai instance Docker Linux lewat SSH, Jupyter, atau portal web. API, CLI, dan Python SDK memungkinkan peluncuran instance diotomatisasi dengan skrip.
Tiga jenis sewa, menurut dokumentasi jenis sewa Vast:
- On-demand: tarif tetap dari host; tidak bisa diinterupsi.
- Interruptible: Anda memasang bid, dan bid yang lebih tinggi bisa menghentikan instance Anda sehingga proses yang berjalan ikut mati. Vast menyebut penghematannya 50–80% dibanding on-demand. Simpan checkpoint sesering mungkin.
- Reserved: bayar di muka untuk diskon hingga 50% tergantung lama komitmen, dengan prioritas on-demand.
Sewa yang aktif ditagih per detik. Jebakannya ada di FAQ penagihan Vast: storage tetap ditagih untuk instance yang dihentikan, dan bandwidth ditagih untuk setiap byte yang dikirim atau diterima. Saat kredit Anda habis, instance dihentikan tetapi tidak dihapus. Dokumentasi Vast tidak menyebutkan deposit minimum.
Pilih Vast.ai jika Anda menginginkan jam GPU termurah dan pekerjaan Anda menyimpan checkpoint dengan cukup baik untuk bid interruptible.
Kekurangannya: harga dan kualitas host bervariasi; di luar Secure Cloud, host dapat mengakses data di mesinnya; tidak ada Windows atau remote desktop. Selengkapnya di ulasan Vast.ai kami.
RunPod vs Vast.ai: mana yang cocok untuk pekerjaan Anda
- Stable Diffusion atau ComfyUI selama beberapa jam: keduanya bisa. Penawaran RTX 3090 dan 4090 di Vast.ai biasanya paling murah; template sekali klik dan tarif tetap RTX 4090 di RunPod lebih sederhana. Di mana pun, hapus disk setelah selesai, atau disk akan terus ditagih.
- Fine-tuning LLM selama akhir pekan: bid interruptible Vast.ai jika skrip Anda menyimpan checkpoint; on-demand RunPod atau Vast jika restart akan merugikan Anda lebih besar daripada penghematannya.
- Menyajikan model sebagai API: RunPod Serverless paling pas, karena endpoint bisa turun ke nol dan tidak ada biaya egress untuk respons.
- Dataset besar: RunPod tidak memungut biaya transfer data; di Vast.ai, periksa harga bandwidth tiap host.
- Data sensitif: RunPod Secure Cloud atau filter Secure Cloud di Vast.ai.
- Apa pun pilihannya: kredit dibayar di muka (kredit RunPod tidak bisa dikembalikan; di Vast.ai kredit yang sudah terpakai bersifat final), jadi isi saldo untuk seminggu, bukan setahun, dan hapus instance yang sudah tidak dipakai, karena disk yang dihentikan tetap ditagih.
Membayar dalam rubel: Timeweb Cloud dan VDSina
Timeweb Cloud mencantumkan server GPU cloud dan dedicated mulai dari GTX 1080 dan RTX 3090/4090 hingga A100 80 GB dan H100 80 GB, dengan H200 tersedia lewat pre-order, di halaman server GPU mereka. Harganya tidak dipublikasikan: Anda mengirim permintaan dan manajer memberikan penawaran, dengan pembayaran di muka minimum 5.000 RUB. Paket ditetapkan per bulan tetapi ditagih per jam. Lihat ulasan Timeweb Cloud.
VDSina menjual server cloud dengan sebagian kapasitas NVIDIA L4 atau L40S di halaman harga GPU mereka: mulai 4.770 RUB per bulan (159 RUB per hari) untuk 8 core, RAM 8 GB, dan memori GPU 2 GB, hingga 25.500 RUB per bulan untuk 32 core dan memori GPU 8 GB, di Moskow atau Amsterdam. Penagihan harian dan tidak ada masa uji coba. Dengan memori GPU 2–8 GB, server ini cocok untuk aplikasi Windows, rendering, dan inferensi ringan, bukan untuk alur kerja Stable Diffusion kelas 24 GB atau fine-tuning LLM. Lihat ulasan VDSina.
Bagaimana dengan Lambda, Paperspace, AWS, dan Google Cloud?
Semuanya pilihan yang layak, tetapi jarang menawarkan jam GPU termurah. Lambda mencantumkan 1x H100 SXM seharga $4,29/jam di halaman harganya (29 Oktober 2026), dengan kapasitas reserved lewat tim sales. Paperspace, yang kini bagian dari DigitalOcean, menawarkan mesin GPU yang berfokus pada notebook. AWS dan Google Cloud punya cakupan region dan kepatuhan paling luas, tetapi kuota dan biaya egress membuat keduanya lebih cocok untuk tim yang memang sudah berjalan di sana.
Untuk VPS, storage, dan infrastruktur lainnya, jelajahi layanan hosting dan cloud.
Pertanyaan umum
GPU cloud mana yang paling murah?
Dihitung per jam, marketplace seperti Vast.ai biasanya punya harga terendah: pada 29 Oktober 2026 feed-nya menunjukkan median RTX 3090 sekitar $0,19/jam dan RTX 3060 sekitar $0,08/jam. GPU termurah yang tercantum di RunPod adalah RTX A5000 seharga $0,16/jam di Community Cloud. Tambahkan biaya storage dan bandwidth sebelum memutuskan.
RunPod vs Vast.ai: mana yang sebaiknya saya pakai?
Gunakan Vast.ai jika harga per jam terendah adalah yang terpenting dan Anda tidak keberatan dengan harga yang ditentukan host serta kualitas yang bervariasi. Gunakan RunPod jika Anda menginginkan daftar harga tetap, endpoint Serverless yang bisa turun ke nol, dan tanpa biaya transfer data.
GPU apa yang perlu saya sewa untuk Stable Diffusion?
Kebanyakan orang memakai kartu 24 GB seperti RTX 3090 atau 4090, yang memberi ruang untuk model yang lebih besar dan alur kerja ComfyUI. Periksa kebutuhan memori model yang persis Anda jalankan. Di RunPod maupun Vast.ai, kartu-kartu ini termasuk yang paling murah untuk disewa.
GPU apa yang saya butuhkan untuk fine-tuning LLM?
Tergantung ukuran model dan metodenya. Fine-tuning gaya LoRA untuk model yang lebih kecil umumnya dilakukan di kartu 24–48 GB, sedangkan fine-tuning penuh atau model yang lebih besar membutuhkan kartu 80 GB seperti A100 atau H100. Periksa panduan memori framework pelatihan Anda sebelum menyewa.
Apakah GPU interruptible atau spot sepadan?
Ya, untuk pekerjaan yang menyimpan checkpoint, karena Vast.ai menyebut penghematan interruptible mencapai 50–80% di bawah on-demand. Saat bid yang lebih tinggi mengambil mesin Anda, proses yang berjalan akan dihentikan, jadi opsi ini kurang cocok untuk demo langsung atau proses panjang tanpa checkpoint.