Mejor nube GPU para IA: dónde alquilar una GPU para Stable Diffusion y fine-tuning de LLM
Alquilar una GPU por horas es la forma más barata de usar Stable Diffusion, hacer fine-tuning de un LLM abierto o servir un modelo sin comprar hardware. Si buscas el precio por hora más bajo, el marketplace de Vast.ai suele ganar; si prefieres precios fijos, endpoints serverless y cero tarifas de egress, RunPod es la opción más sencilla. Esta guía es para desarrolladores, investigadores y aficionados que pagan su propio tiempo de GPU: precios publicados el 29 de octubre de 2026, spot vs on-demand, almacenamiento y egress.
Comparativa rápida
| Servicio | Ideal para | Precio desde | Plan gratuito / prueba | Límite principal | Reseña y registro |
|---|---|---|---|---|---|
| RunPod | Precios de GPU fijos por segundo, endpoints serverless, sin tarifas de egress | Desde $0.16/h (RTX A5000, Community Cloud) | Sin plan gratuito; empiezas con $10, crédito de registro tras los primeros $10 | Créditos no reembolsables; pods sin network volume eliminados con saldo $0 | Reseña de RunPod →Ir a RunPod → |
| Vast.ai | Precios por hora más bajos y pujas interrumpibles en un marketplace | Mediana RTX 3090 ~$0.19/h (29 oct 2026) | Sin plan gratuito ni código promocional | Precios fijados por el host; almacenamiento y ancho de banda aparte | Reseña de Vast.ai →Ir a Vast.ai → |
| Timeweb Cloud | GPU de centro de datos completas (hasta H100) facturadas en rublos | Presupuesto a petición; anticipo mínimo de 5000 RUB | Sin prueba gratuita | Sin lista pública de precios GPU; planes mensuales cobrados por hora | Reseña de Timeweb Cloud →Ir a Timeweb Cloud → |
| VDSina | Porciones pequeñas de L4/L40S en rublos para apps de Windows e inferencia ligera | 4770 RUB/mes (159 RUB/día) | Sin prueba; facturación diaria | 2–8 GB de memoria de GPU por servidor | Reseña de VDSina →Ir a VDSina → |
Aviso: los botones de registro de esta tabla son enlaces de afiliado. Si te registras a través de uno, podemos recibir una comisión sin coste adicional para ti. Las comisiones no deciden qué servicios incluimos ni lo que decimos de ellos.
La respuesta corta
Para la mayoría de quienes alquilan una GPU por horas, la elección está entre dos modelos:
- Elige Vast.ai si lo que más te importa es el precio. Es un marketplace: hosts independientes y centros de datos publican sus máquinas y fijan sus propias tarifas, así que normalmente ahí encuentras el precio por hora más bajo, y las pujas interrumpibles bajan todavía más. A cambio pierdes previsibilidad: precios, fiabilidad y calidad de red varían de un host a otro.
- Elige RunPod si quieres precios fijos y buscar menos. Publica una única tarifa por hora para cada GPU, en una Community Cloud más barata y una Secure Cloud más cara, añade endpoints Serverless que escalan a cero y no cobra por transferencia de datos.
¿Pagas en rublos? Timeweb Cloud y VDSina alquilan servidores con GPU en planes mensuales. Los precios de abajo son los publicados el 29 de octubre de 2026; las tarifas de GPU cambian cada semana, así que revisa la página en vivo antes de recargar saldo.
Cómo elegir una nube GPU
La tarifa por hora es solo una línea de la factura. Lo que decide el coste real:
- Primero la VRAM, después la velocidad. El modelo tiene que caber en la memoria de la GPU. La generación de imágenes con Stable Diffusion o ComfyUI y el fine-tuning LoRA de modelos pequeños suelen hacerse en tarjetas de consumo de 24 GB (RTX 3090, 4090) o en la RTX 5090 de 32 GB. El fine-tuning completo o servir LLM más grandes te lleva a 48 GB (L40S) o a 80 GB y más (A100, H100, H200, B200).
- Modelo de precios. Una lista de precios fija (RunPod) frente a precios de marketplace fijados por cada host (Vast.ai).
- On-demand vs interrumpible. La capacidad on-demand funciona hasta que tú la detienes. La capacidad interrumpible (spot) es más barata, pero te la pueden quitar, así que encaja con trabajos que guardan checkpoints.
- Almacenamiento y egress. Los discos suelen seguir facturando con la GPU detenida, y algunos proveedores cobran cada byte que entra o sale.
- Granularidad de facturación y depósito mínimo. La facturación por segundo abarata los experimentos cortos; un depósito mínimo alto o un crédito no reembolsable encarecen probar un proveedor.
- Serverless. Si sirves un modelo detrás de una API, pagar solo mientras se ejecutan las peticiones puede salir mejor que tener una GPU encendida todo el día.
- Confianza y datos. ¿Quién es el dueño de la máquina y puede ver tus datos?
Marketplace vs Secure Cloud y Community Cloud
En la página de precios de Vast.ai no hay un precio único por GPU. Los hosts instalan el software de Vast, publican sus máquinas y fijan la tarifa, que depende del modelo de GPU, la fiabilidad, la red y la ubicación. Vast ofrece más de 68 tipos de GPU. Las propias FAQ de Vast advierten que los hosts pueden acceder a los datos de sus máquinas, por eso recomiendan su filtro Secure Cloud (centros de datos verificados con certificación ISO 27001 y/o Tier 3/4) para trabajo sensible o de producción.
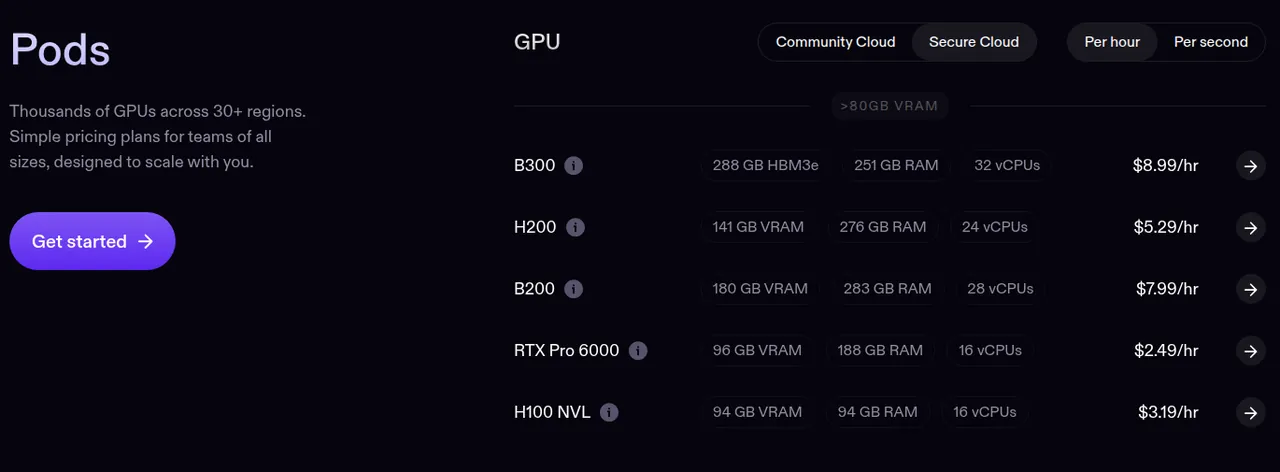
RunPod divide su capacidad en dos. Community Cloud es capacidad más barata de hosts verificados; Secure Cloud funciona en los centros de datos asociados de RunPod. La misma GPU cuesta más en Secure Cloud: una RTX 4090 sale a $0.34/h en Community Cloud y a $0.89/h en Secure Cloud según la página de precios de RunPod.
Para una sesión de hobby o un fine-tuning con un dataset público, el nivel barato está bien; para datos de clientes o pesos privados, paga el nivel verificado.
Precios de GPU lado a lado
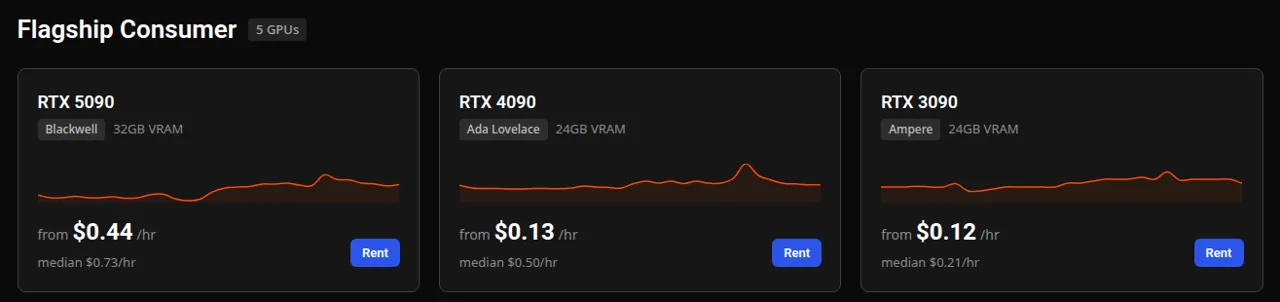
Las tarifas de RunPod son sus precios on-demand publicados para pods. Las de Vast.ai son la mediana actual de las ofertas en vivo de su feed público de precios; cada host puede estar por encima o por debajo de esa mediana. Todo por GPU y hora, según lo publicado el 29 de octubre de 2026.
| GPU | VRAM | RunPod Community | RunPod Secure | Mediana Vast.ai |
|---|---|---|---|---|
| RTX 3090 | 24 GB | $0.22 | $0.50 | $0.19 |
| RTX 4090 | 24 GB | $0.34 | $0.89 | $0.50 |
| RTX 5090 | 32 GB | $0.69 | $1.19 | $0.71 |
| L40S | 48 GB | $0.79 | $1.09 | $0.69 |
| A100 SXM | 80 GB | $1.39 | $1.79 | $0.80 |
| H100 SXM | 80 GB | $2.69 | $3.99 | $2.40 |
| H200 | 141 GB | $3.59 | $5.29 | $5.05 |
| B200 | 180–192 GB | $5.98 | $7.99 | $8.75 |
En el marketplace, la RTX 3090 y la A100 quedaron por debajo de las tarifas fijas de RunPod (y la mediana de una RTX 3060 rondaba los $0.08/h), mientras que en la H200 y la B200 las tarifas Community de RunPod fueron más bajas ese día. Ninguno es siempre más barato: compara la GPU exacta el día que vayas a alquilar.
RunPod: lo mejor para pods previsibles y serverless
RunPod alquila GPU NVIDIA desde la RTX A5000 ($0.16/h en Community Cloud) hasta la H200, la B200 y la B300. Sus productos:
- Pods: instancias con GPU por SSH o Jupyter.
- Serverless: endpoints que escalan a cero cuando están inactivos, facturados por segundo de tiempo de worker, por ejemplo $0.69/h para GPU de 24 GB y $4.79/h para una H100.
- Clusters: capacidad multi-GPU para entrenamiento distribuido.
Según la documentación de facturación de RunPod, cómputo y almacenamiento se facturan por segundo, sin tarifas por transferencia de datos, y puedes empezar con $10. El almacenamiento es de donde salen los costes en reposo: un volume disk cuesta $0.10/GB al mes mientras el pod funciona y $0.20/GB al mes mientras está detenido; los network volumes cuestan $0.07/GB al mes por debajo de 1 TB.
Elige RunPod si quieres una tarifa por hora conocida, servir modelos con escalado a cero o no tener factura de egress.
Las desventajas: los créditos no son reembolsables. Con saldo cero, los pods se detienen y los que no tienen network volume se eliminan junto con sus datos. La página de precios no muestra tarifas spot. Los detalles y el crédito de registro están en nuestra reseña de RunPod.
Vast.ai: lo mejor para el precio por hora más bajo
La fortaleza de Vast.ai es la variedad: filtras ofertas por GPU, VRAM, fiabilidad, ubicación y precio, y alquilas la máquina como una instancia Docker de Linux por SSH, Jupyter o un portal web. Una API, una CLI y un SDK de Python permiten automatizar los lanzamientos.
Tres tipos de alquiler, según la documentación de tipos de alquiler de Vast:
- On-demand: la tarifa fija del host; no se puede interrumpir.
- Interrumpible: tú fijas una puja y una puja más alta puede detener tu instancia, matando los procesos en ejecución. Vast cifra el ahorro en un 50–80% frente a on-demand. Guarda checkpoints a menudo.
- Reservado: pagas por adelantado a cambio de un descuento de hasta el 50% según la duración del compromiso, con prioridad on-demand.
Los alquileres activos se facturan por segundo. La trampa está en las FAQ de facturación de Vast: el almacenamiento se cobra también con las instancias detenidas, y el ancho de banda se cobra por cada byte enviado o recibido. Cuando tu crédito llega a cero, las instancias se detienen pero no se destruyen. La documentación de Vast no indica un depósito mínimo.
Elige Vast.ai si quieres la hora de GPU más barata y tus trabajos guardan checkpoints lo bastante bien como para usar pujas interrumpibles.
Las desventajas: los precios y la calidad de los hosts varían; fuera de Secure Cloud, un host puede acceder a los datos de su máquina; no hay Windows ni escritorio remoto. Más en nuestra reseña de Vast.ai.
RunPod vs Vast.ai: cuál para tu trabajo
- Stable Diffusion o ComfyUI durante unas horas: ambos sirven. Las ofertas de RTX 3090 y 4090 de Vast.ai suelen ser las más baratas; las plantillas de un clic de RunPod y su tarifa fija para la RTX 4090 son más sencillas. En los dos, borra el disco cuando termines o seguirá facturando.
- Fine-tuning de un LLM durante un fin de semana: pujas interrumpibles de Vast.ai si tu script guarda checkpoints; RunPod o Vast on-demand si un reinicio te costaría más que lo que ahorras.
- Servir un modelo como API: RunPod Serverless es lo que mejor encaja, porque los endpoints escalan a cero y no hay tarifas de egress por las respuestas.
- Datasets grandes: RunPod no cobra por transferencia de datos; en Vast.ai, revisa el precio de ancho de banda de cada host.
- Datos sensibles: RunPod Secure Cloud o el filtro Secure Cloud de Vast.ai.
- En cualquier caso: el crédito es prepago (el de RunPod no es reembolsable; en Vast.ai el crédito gastado es definitivo), así que recarga para la semana, no para el año, y destruye las instancias que ya no uses, porque los discos detenidos siguen facturando.
Pagar en rublos: Timeweb Cloud y VDSina
Timeweb Cloud ofrece servidores GPU en la nube y dedicados, desde la GTX 1080 y las RTX 3090/4090 hasta la A100 80 GB y la H100 80 GB, con la H200 en preventa, en su página de servidores GPU. Los precios no se publican: dejas una solicitud y un gestor te pasa presupuesto, con un pago anticipado mínimo de 5000 RUB. Los planes se fijan por mes, pero se cobran por hora. Consulta la reseña de Timeweb Cloud.
VDSina vende servidores en la nube con una porción de una NVIDIA L4 o L40S en su página de precios GPU: desde 4770 RUB al mes (159 RUB al día) por 8 núcleos, 8 GB de RAM y 2 GB de memoria de GPU, hasta 25 500 RUB al mes por 32 núcleos y 8 GB de memoria de GPU, en Moscú o Ámsterdam. La facturación es diaria y no hay prueba. Con 2–8 GB de memoria de GPU, sirven para aplicaciones de Windows, renderizado e inferencia ligera, no para flujos de Stable Diffusion de clase 24 GB ni para fine-tuning de LLM. Consulta la reseña de VDSina.
¿Y Lambda, Paperspace, AWS y Google Cloud?
Son opciones reales, pero rara vez la hora más barata. Lambda publica una 1x H100 SXM a $4.29/h en su página de precios (29 de octubre de 2026), con capacidad reservada a través de ventas. Paperspace, ahora parte de DigitalOcean, ofrece máquinas GPU centradas en notebooks. AWS y Google Cloud aportan la mayor cobertura de regiones y cumplimiento normativo, pero las cuotas y los cargos de egress los hacen más adecuados para equipos que ya trabajan allí.
Para VPS, almacenamiento y otra infraestructura, explora los servicios de hosting y nube.
Preguntas frecuentes
¿Cuál es la nube GPU más barata?
Por hora, los marketplaces como Vast.ai suelen tener los precios más bajos: el 29 de octubre de 2026 su feed mostraba una mediana de unos $0.19/h para la RTX 3090 y de unos $0.08/h para la RTX 3060. La GPU más barata publicada por RunPod era una RTX A5000 a $0.16/h en Community Cloud. Suma almacenamiento y ancho de banda antes de decidir.
RunPod vs Vast.ai: ¿cuál debo usar?
Usa Vast.ai cuando lo que más importa es el precio por hora más bajo y puedes convivir con precios fijados por el host y una calidad variable. Usa RunPod cuando quieras una lista de precios fija, endpoints Serverless que escalan a cero y cero tarifas por transferencia de datos.
¿Qué GPU necesito alquilar para Stable Diffusion?
La mayoría usa una tarjeta de 24 GB como la RTX 3090 o la 4090, que deja margen para modelos más grandes y flujos de ComfyUI. Revisa los requisitos de memoria del modelo exacto que vayas a usar. Tanto en RunPod como en Vast.ai, estas tarjetas están entre las más baratas de alquilar.
¿Qué GPU necesito para hacer fine-tuning de un LLM?
Depende del tamaño del modelo y del método. El fine-tuning tipo LoRA de modelos pequeños se hace habitualmente en tarjetas de 24–48 GB, mientras que el fine-tuning completo o los modelos más grandes necesitan tarjetas de 80 GB como la A100 o la H100. Consulta las recomendaciones de memoria de tu framework de entrenamiento antes de alquilar.
¿Merecen la pena las GPU interrumpibles o spot?
Sí, para trabajos que guardan checkpoints, ya que Vast.ai cifra el ahorro de las interrumpibles en un 50–80% frente a on-demand. Cuando una puja más alta se queda con tu máquina, los procesos en ejecución se matan, así que no son buena opción para demos en vivo ni para ejecuciones largas sin checkpoints.